Bean数据集
教学视频
概述
Bask Report 支持 Bean 数据集:你可以在当前集成 BaskReport 的 Java 项目中,通过 Java API 为 Dataset 提供 Bean 类型的数据源。
如果数据可以通过 Restful 接口获取,强烈建议使用统一数据源中的 API 数据源 代替 Bean 数据集。
Bask Report 基于 java.util.ServiceLoader 机制加载自定义的 Bean 数据源,对应的抽象类全路径为 com.basksoft.report.core.model.dataset.BeanDataset。
核心抽象类
自定义数据集需继承 BeanDataset 并实现以下方法:
public abstract class BeanDataset extends Dataset {
    public BeanDataset() {
        super(null,null);
    }
    /**
     * @param context 上下文对象,从中可以获取报表参数,和需要的单元格值
     * @return 返回数据集数据
     */
    public abstract List<?> getData(BeanContext context);

    /**
     * @return 返回当前数据集在计算时需要依赖的单元格名称,如果不依赖单元格返回null或空的List
     */
    public abstract List<String> getDependCells();

    /**
     * @return 返回当前数据集名称,不能返回空
     */
    protected abstract String name();

    /**
     * @return 返回当前数据集对应的字段集合,不能为空
     */
    public abstract List<Field> getFields();

    @Override
    public final String getName() {
        return name();
    }
}
其中,BeanContext 提供了以下上下文信息:
parameters:报表参数集合变量,可用于查询过滤数据的参数判断。参数定义可参考:报表参数。cellsMap:当前报表计算所需的单元格值集合。tenantId:当前请求的租户标识(由框架在构造BeanContext时通过ContextHolder.getTenantId()注入),用于在getData内区分不同租户的数据。
在 getData 中按租户取数的示例:
@Override
public List<?> getData(BeanContext context) {
    String tenantId = context.getTenantId();   // 当前租户标识
    Object param = context.getReportParameter("date"); // 报表参数
    // 根据 tenantId 与 param 查询并返回数据
    return queryByTenant(tenantId, param);
}
由于 Bean 数据集是全局共享、与租户定义无关(见「特别说明(全局性)」),不要在实现类中缓存租户状态,而应每次取数时通过
context.getTenantId()获取。
分类
在设计器的数据集选择列表中,Bean 数据集会按 分类 进行分组展示,便于在数据集较多时快速定位。每个数据集的分类由以下规则确定(优先级从高到低):
SPI 配置文件声明(推荐):在
META-INF/services/com.basksoft.report.core.model.dataset.BeanDataset文件中,每行登记一个实现类,并可附带# 分类名声明其所属分类。例如:# BeanDataset SPI 注册文件,每个实现类占一行 # 格式:<实现类全限定名> [ # <分类名> ] com.demo.TaskDataset # 任务统计 com.demo.UserDataset # 用户中心 com.demo.BillDataset # 海运 com.demo.SeaBookingDataset # 海运 com.demo.AirCargoDataset # 空运- 以
#开头的行视为注释,空行会被忽略;#前后允许有空格。 - 同一分类名下可登记多个数据集,设计器会将其归并为同一分组(如
海运 (2))。 - 同一实现类只需登记一次;重复登记(如示例文件中的
TestBeanDataset出现两次)会被框架去重,建议保持唯一。
- 以
重写
getCategory()方法:在BeanDataset子类中重写该方法,返回自定义分类名称。默认分类:若既未在 SPI 中声明也未重写方法,则统一归入
默认分类。
public String getCategory() {
    return "默认分类";
}
三种方式的优先级为:SPI 声明 > getCategory() 返回值 > 默认分类。当同一分类下存在多个数据集时,设计器会以分组标题(如
任务统计 (3))的形式展示数量。
前期准备(ServiceLoader 定义)
按以下步骤使用 Bean 数据集:
在
resources资源目录下创建META-INF/services文件夹。在
services文件夹中创建文件,以接口全名命名:com.basksoft.report.core.model.dataset.BeanDataset。创建接口实现类,参考代码:
public class TaskDataset extends BeanDataset {
 @SuppressWarnings("unused")
 private static int number = 1;

 @Override
 public List<?> getData(BeanContext context) {
     List<Map<String,Object>> datas=new ArrayList<Map<String,Object>>();
     Map<String, Object> data = new HashMap<String, Object>();
     data.put("collectionAll", RandomUtils.nextInt(5000000));
     data.put("category1", RandomUtils.nextInt(30));
     data.put("category2", RandomUtils.nextInt(3000));
     data.put("category3", RandomUtils.nextInt(30));
     data.put("category4", RandomUtils.nextInt(30));
     data.put("category5", RandomUtils.nextInt(30));
     data.put("category6", RandomUtils.nextInt(300000));
     datas.add(data);
     return datas;
 }

 @Override
 public List<String> getDependCells() {
     return null;
 }

 @Override
 protected String name() {
     return "执行任务统计";
 }

 @Override
 public List<Field> getFields() {
     List<Field> fields = new ArrayList<Field>();
     fields.add(new Field("collectionAll", "统计所有", FieldType.Integer));
     fields.add(new Field("category1", "分类1", FieldType.Integer));
     fields.add(new Field("category2", "分类2", FieldType.Integer));
     fields.add(new Field("category3", "分类3", FieldType.Integer));
     fields.add(new Field("category4", "分类4", FieldType.Integer));
     fields.add(new Field("category5", "分类5", FieldType.Integer));
     fields.add(new Field("category6","分类6", FieldType.Integer));
     return fields;
 }

 }
在
META-INF/services/com.basksoft.report.core.model.dataset.BeanDataset文件中登记实现类,每行一个,如需指定分类则追加# 分类名:xxx.xxx.xxx.TaskDataset # 任务统计 xxx.xxx.xxx.BillDataset # 海运详见上文「分类」一节:未声明
# 分类名时归入默认分类;分类按 SPI 声明 > getCategory() 返回值 > 默认分类 的优先级确定。
设计器使用
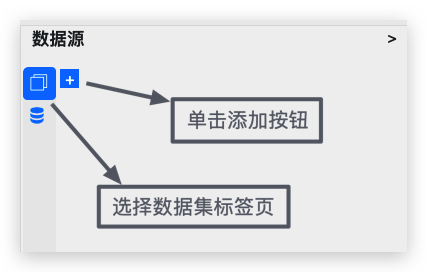
在数据源设置面板中,选择第一个数据集标签页,并单击添加按钮:
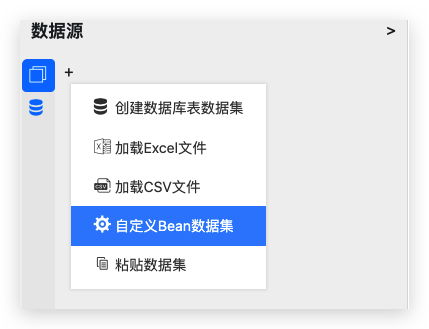
在弹出菜单中选择创建自定义 Bean 数据集:
在弹出向导窗口中选择需要添加的 Bean 数据集对象:
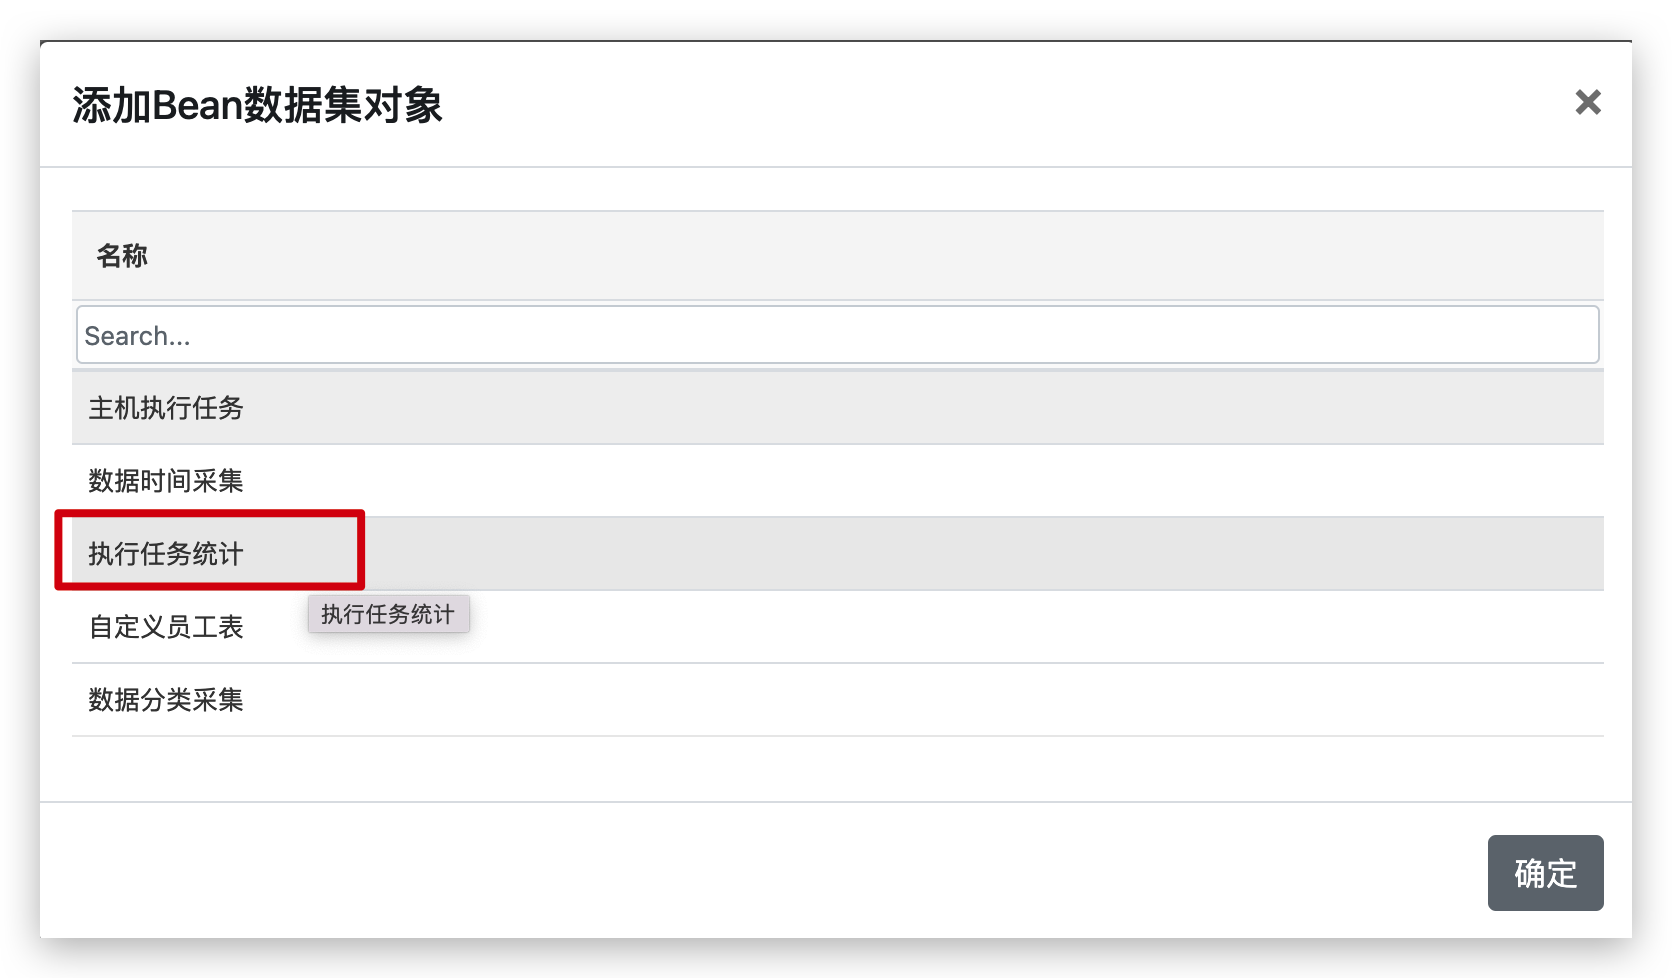
选中 Bean 数据集对象,并单击确定按钮,即完成 Bean 数据集的添加。
特别说明(全局性)
Bean 数据集是通过 java.util.ServiceLoader 在 JVM 进程内 加载的,属于 全局共享 资源,与租户无关:
- 一经注册,所有租户在设计器中选择 Bean 数据集时,看到的都是同一份实现类列表,不存在按租户隔离的 Bean 数据集。
- 数据集的
getData(BeanContext)等方法在每次取数时都会重新调用,因此不要在实现类中缓存与租户相关的状态(如通过ThreadLocal、静态变量保存租户数据),否则会造成租户间数据串扰。 - 若不同租户需要不同的取数逻辑,应在方法体内根据
BeanContext中的报表参数自行区分,而非依赖 Bean 数据集层面的租户隔离。
实例全局唯一:BeanDataset 实现类经 ServiceLoader 加载后,由 BeanDatasetUtils 以 static 集合缓存且仅创建一个实例,所有报表、所有请求通过 getBeanDataset(name) 拿到的都是同一个对象引用。因此:
- 不同报表使用同一个 Bean 数据集时,会共用同一个实例;若实现类中保存了可变实例字段(或静态字段),报表之间会相互覆盖、并发时还会产生数据串扰。
- 实现类必须保持无状态:所有可变数据(查询结果、临时变量等)都应在
getData(BeanContext)方法体内以局部变量产生,不写入实例字段或静态字段。 - 若确实需要缓存(如耗时查询),缓存 key 必须包含
tenantId与报表参数,并注意并发安全。
设计器计算字段相互隔离:在报表设计器中为 Bean 数据集添加的计算字段不会在不同报表间相互影响。原因是框架在构建报表时会通过 new BeanDatasetWrapper(beanDataset) 每次新建一个包装器对象,并将该报表配置的计算字段 regist 到这个 Wrapper 上(DatasetBuilder 中的 registComputedFieldMap),而非写入那个全局唯一的 BeanDataset 实例。由于每个报表构建都会生成各自独立的 Wrapper,因此报表 A 的计算字段只存在于报表 A 的 Wrapper 中,不会串到报表 B。
注意:上述隔离成立的前提是计算字段由设计器配置、经框架注入。若你在
BeanDataset实现类的getFields()中自行动态返回计算字段并依赖了可变状态,则仍会受"实例全局唯一"影响而相互干扰,应避免这种做法。简而言之:Bean 数据集是"全局定义、实例唯一、按调用隔离数据、按报表隔离计算字段",而非"按租户或按报表隔离的定义"。
获取当前租户
该功能自 2.3.2+ 版本开始支持,低版本
BeanContext无getTenantId()方法。
虽然 Bean 数据集的定义是全局共享、与租户无关的,但在一次具体的取数调用中,框架会自动将当前租户标识注入到 BeanContext 中,供实现类使用:
- 租户标识来源于
com.basksoft.core.ContextHolder.getTenantId(),由框架在构造BeanContext时自动传入(构造方法签名为BeanContext(parameters, cellsMap, tenantId))。 - 实现类通过
context.getTenantId()获取,无需自行解析ContextHolder。 若取数发生在异步线程或由定时任务触发,
ContextHolder中的租户上下文可能为空,此时可在调用处显式传入租户标识:// 调用方显式指定租户,避免异步场景丢失 dataset.getData(new BeanContext(parameters, cellsMap, currentTenantId));
注意事项
如果项目整合了 Spring,需要注意的是,在通过 SPI 创建 ServiceLoader 时,Spring 尚未完成初始化,因此以下用法不会生效:
public class TaskDataset extends BeanDataset {
    @SuppressWarnings("unused")
    private static int number = 1;

    // spring中的annotation标记不会起作用
    @Value("smtp.user")
    private String smtpUser;

    // spring中的annotation标记不会起作用
    @Autowired
    private DataService dataservice;

    // 直接通过Spring的ApplicationContext获取Bean也是不行的
    private UserService userService = SpringUtils.getBean(UserService.class);

    ...

}
正确的做法是在方法内部访问 Spring 资源,例如:
public class TaskDataset extends BeanDataset {
    @SuppressWarnings("unused")
    private static int number = 1;

    @Override
    public List<Field> getFields() {
        FieldService fieldService = SpringUtils.getBean(FieldService.class)
        ...
    }

    ...

}